ما هو الذكاء الاصطناعي متعدد الوسائط؟ وكيف يجمع النصوص والصور والصوت؟
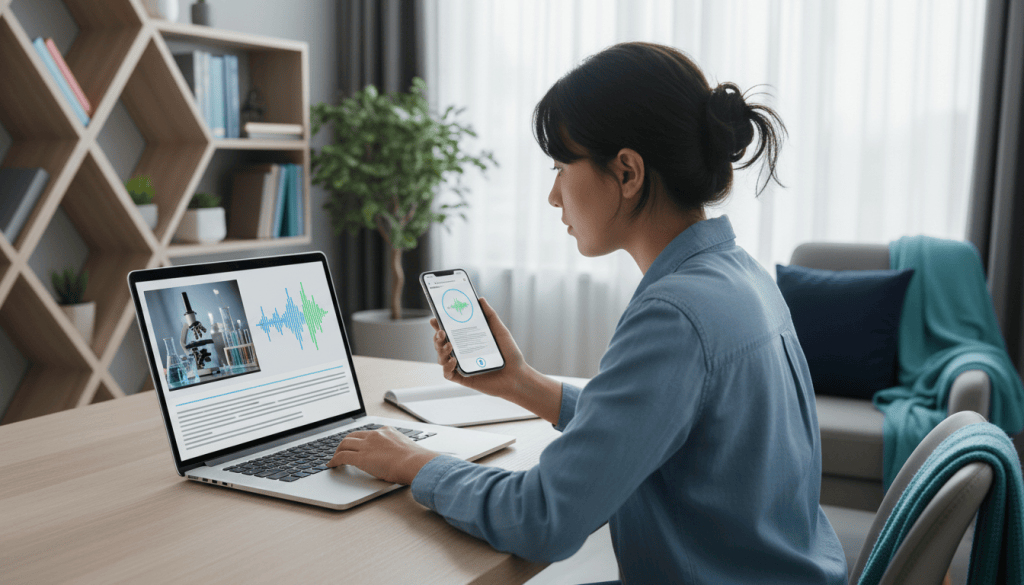
تخيّل أنك ترفع صورة لمخطط كهربائي، ثم تسأل مساعدًا ذكيًا بصوتك: «ما وظيفة هذا الجزء؟». لكي يجيب بصورة مفيدة، يحتاج النظام إلى فهم الصورة والكلام معًا، وربطهما بالسؤال. هذا مثال على الذكاء الاصطناعي متعدد الوسائط (Multimodal AI)، الذي يتعامل مع أكثر من نوع من البيانات بدل الاقتصار على النص وحده.
أصبحت هذه الأنظمة مهمة في التعليم وخدمة العملاء وتحليل الفيديو والصور والتفاعل الصوتي. لكن جمع أنواع البيانات لا يعني أن النموذج يفهم كل شيء تلقائيًا؛ فالدقة تعتمد على جودة المدخلات، وطريقة دمجها، وقدرة النموذج على الاستدلال والتحقق من النتائج.
ما هو الذكاء الاصطناعي متعدد الوسائط؟
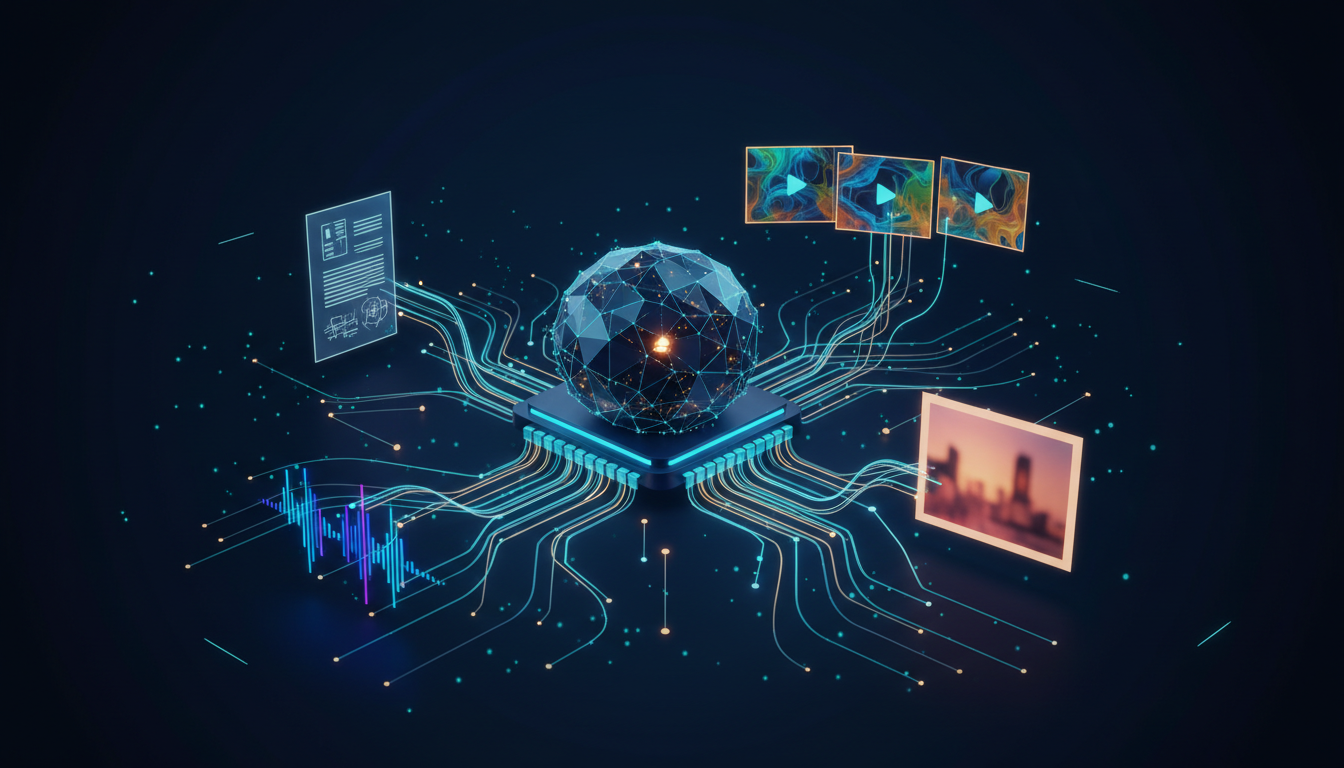
الذكاء الاصطناعي متعدد الوسائط هو نوع من أنظمة التعلم الآلي يستطيع معالجة أكثر من نمط من البيانات وربط المعلومات بينها. وتشمل الوسائط الشائعة النصوص والصور والصوت والفيديو، وقد تشمل أيضًا بيانات المستشعرات أو الإشارات المكانية.
على سبيل المثال، يستطيع نظام أحادي الوسيط التعامل مع سؤال مكتوب فقط، بينما يمكن لنظام متعدد الوسائط أن يستقبل السؤال نفسه مع صورة أو تسجيل صوتي أو مقطع فيديو، ثم يستخدم السياقات المختلفة لصياغة استجابة واحدة. وقد تكون المخرجات نصًا أو صوتًا أو صورة، بحسب النموذج والتطبيق.
ترتبط هذه التقنية بتطور الذكاء الاصطناعي التوليدي، لكنها أوسع من مجرد إنشاء محتوى؛ فهي تشمل أيضًا فهم البيانات وتحليلها وربطها ببعضها.

ما أنواع البيانات التي يمكن للنظام متعدد الوسائط فهمها؟
- النصوص: الأسئلة والمستندات والتعليمات والرسائل.
- الصور: الصور الفوتوغرافية والرسوم والمخططات ولقطات الشاشة.
- الصوت: الكلام البشري والمقاطع الصوتية والأصوات المحيطة.
- الفيديو: تسلسل الإطارات المرئية، وقد يتضمن الصوت والتوقيت بحسب طريقة المعالجة.
- البيانات الحسية والمكانية: مثل قراءات الكاميرات وأجهزة الاستشعار ومعلومات الحركة في بعض التطبيقات المتخصصة.
ليس من الضروري أن يدعم كل نموذج جميع هذه الأنواع، كما أن دعم الوسيط لا يعني بالضرورة إمكان إدخاله وإخراجه بالطريقة نفسها. لذلك يجب مراجعة مواصفات النموذج والواجهة البرمجية قبل بناء التطبيق.
كيف يعمل الذكاء الاصطناعي متعدد الوسائط؟
تختلف البنية الداخلية بين النماذج، لكن النظام يحتاج عادةً إلى تحويل كل نوع من البيانات إلى تمثيل يستطيع النموذج معالجته، ثم ربط المعلومات ذات الصلة قبل توليد الإجابة. ويمكن تبسيط العملية في المراحل التالية:
1. استقبال البيانات وتجهيزها
يستقبل النظام النص أو الصورة أو الصوت أو الفيديو. وقد يجزئ الفيديو إلى إطارات، أو يحول الصوت إلى تمثيل رقمي، أو يقسم المستند إلى أجزاء. وتختلف خطوات التجهيز وفق نوع البيانات والمهمة المطلوبة.
2. استخراج السمات وبناء التمثيلات
تُحوّل البيانات إلى تمثيلات رقمية تسمح للنموذج بالتعامل معها. فقد يلتقط تمثيل الصورة عناصرها وأشكالها، بينما يلتقط تمثيل الصوت الكلمات أو الخصائص الصوتية. وفي بعض الأنظمة تُستخدم فضاءات تمثيل مشتركة لتقريب المعلومات المتشابهة في المعنى حتى لو جاءت من وسيطين مختلفين.
3. محاذاة المعلومات ودمجها
يحتاج النظام إلى معرفة العلاقة بين الأجزاء المختلفة. فمثلًا، يجب ربط العبارة المنطوقة بالجزء المناسب من الصورة أو ربط حدث في الفيديو بالتوقيت الذي وقع فيه. وتسمى هذه العملية محاذاة الوسائط (Alignment)، أما دمج المعلومات فيسمى Fusion.
يمكن أن يحدث الدمج مبكرًا عند تجهيز المدخلات، أو في مراحل وسطية أثناء معالجة النموذج، أو متأخرًا بعد أن تحلل نماذج متخصصة كل وسيط على حدة ثم تجمع النتائج. ولا توجد طريقة واحدة مناسبة لكل التطبيقات.
4. الاستدلال وتوليد المخرجات
بعد ربط المعلومات، يستخدم النموذج السياق المتاح للإجابة أو التصنيف أو التلخيص أو إنشاء محتوى جديد. وقد يشرح صورة، أو يلخص اجتماعًا مصورًا، أو يرد بصوت، أو يجمع بين نص وصورة في نتيجة واحدة.

ما الفرق بين الذكاء الاصطناعي أحادي الوسيط ومتعدد الوسائط؟
| وجه المقارنة | أحادي الوسيط | متعدد الوسائط |
|---|---|---|
| المدخلات | نوع واحد غالبًا، مثل النص أو الصورة | نوعان أو أكثر بحسب قدرات النظام |
| السياق | يعتمد على المعلومات المتاحة في الوسيط الواحد | يمكنه ربط معلومات من مصادر مختلفة |
| المخرجات | عادةً من نوع واحد | قد تكون نصًا أو صوتًا أو صورة أو مزيجًا منها |
| التعقيد | أبسط نسبيًا في التجهيز والتقييم | يتطلب محاذاة الوسائط وإدارة أخطائها وخصوصيتها |
أمثلة عملية على استخدام الذكاء الاصطناعي متعدد الوسائط
1. شرح صورة أو مخطط تعليمي
يمكن للطالب إرفاق صورة لمسألة فيزياء أو مخطط علمي، ثم كتابة سؤال يحدد الجزء الذي لم يفهمه. يستطيع النظام الجمع بين ما يظهر في الصورة والسؤال النصي لتقديم شرح أكثر ارتباطًا بالمطلوب، مع ضرورة مراجعة المعادلات والنتائج.
2. تحليل تسجيل صوتي أو فيديو
يمكن استخدام النظام لتلخيص اجتماع، أو استخراج النقاط المهمة من محاضرة، أو البحث عن حدث داخل مقطع فيديو. تعتمد دقة النتيجة على وضوح الصوت، وجودة الصورة، والتوقيت، وطريقة أخذ عينات الإطارات أو معالجة المسار الصوتي.
3. خدمة العملاء والتجارة الإلكترونية
قد يرسل العميل صورة لمنتج تالف مع وصف المشكلة، فيجمع النظام بين العلامات المرئية والشرح المكتوب لتوجيه الطلب إلى القسم المناسب. لكن لا ينبغي أن يتخذ قرارًا نهائيًا في المطالبات أو الضمانات دون قواعد واضحة ومراجعة بشرية عند الحاجة.
4. دعم الوصول لذوي الإعاقة
يمكن لبعض التطبيقات وصف المشاهد بصوت، أو تحويل الكلام إلى نص، أو مساعدة المستخدم على فهم محتوى بصري. ويجب اختبار هذه الوظائف مع المستخدمين الفعليين، لأن الوصف قد يغفل تفاصيل مهمة أو يخطئ في تفسير المشهد.
Prompt عربي عملي لتحليل صورة مع سؤال
يمكنك تجربة التعليمات التالية مع نموذج يدعم إدخال الصور والنصوص. أرفق صورة واضحة، ثم استخدم هذا الطلب:
حلّل الصورة المرفقة بوصفها مصدرًا للمعلومات، ثم أجب عن سؤالي: [اكتب السؤال هنا]. ابدأ بوصف العناصر التي تستطيع رؤيتها فقط، وافصل بين الملاحظات والاستنتاجات. إذا كانت هناك كتابة أو أرقام في الصورة فانقلها كما تظهر، ولا تخمّن الأجزاء غير الواضحة. اشرح الإجابة خطوة بخطوة بلغة عربية بسيطة، واذكر ما لا تستطيع التأكد منه.
تساعد هذه التعليمات على طلب وصف منفصل عن الاستنتاج، لكنها لا تضمن خلو الإجابة من الأخطاء. إذا كانت الصورة تحتوي على قياسات أو معادلات، فتحقق منها باستخدام مصدر أو أداة حساب مستقلة.
أمثلة على أدوات تدعم مهام متعددة الوسائط
تختلف الوظائف بحسب النموذج والخطة والواجهة المستخدمة، لكن يمكن استكشاف أمثلة من المنصات الرسمية التالية:
- Google Gemini: يمكن تجربة فهم الصور والمحتوى المرئي، كما توضح وثائق Gemini API Image Understanding وVideo Understanding طرق إرسال الصور والفيديو إلى النماذج المدعومة.
- ChatGPT: تختلف قدرات الصور والصوت باختلاف التجربة والنموذج. وتشرح وثائق OpenAI Images and Vision إدخال الصور وتحليلها عبر الواجهات البرمجية.
قبل اختيار أداة، تحقق من أنواع الملفات المدعومة وحدود الحجم والمدة، ومن سياسة الاحتفاظ بالبيانات. لا تفترض أن ميزة متاحة في واجهة المستخدم متاحة بالطريقة نفسها في API أو في جميع الخطط.
وإذا كنت تريد فهم كيفية استرجاع المعلومات المساندة للإجابة، يمكنك قراءة شرح تقنية التوليد المعزز بالاسترجاع RAG، وهي طريقة مختلفة يمكن دمجها مع تطبيقات الذكاء الاصطناعي لتزويدها بمصادر خارجية ذات صلة.
ما تحديات الذكاء الاصطناعي متعدد الوسائط؟
- الهلوسة وسوء التفسير: قد يخطئ النموذج في قراءة نص داخل صورة أو تحديد عنصر أو فهم نبرة صوت.
- ضعف المحاذاة: قد يربط النظام تعليقًا صوتيًا بإطار غير مناسب أو يخلط بين عناصر متشابهة.
- الخصوصية: قد تكشف الصور والتسجيلات عن وجوه أو أصوات أو مواقع أو مستندات خاصة؛ لذلك لا ترفع بيانات حساسة دون التأكد من صلاحيات الاستخدام وسياسة الخدمة.
- التحيز: قد تختلف جودة التعرف على الوجوه أو اللهجات أو المشاهد باختلاف البيانات التي تدرب عليها النظام.
- التكلفة والوقت: معالجة الفيديو أو الملفات الكبيرة قد تتطلب موارد أكبر من معالجة نص قصير.
- صعوبة التقييم: لا يكفي تقييم صحة النص وحده؛ بل يجب اختبار فهم الصورة والصوت والعلاقة بين الوسائط أيضًا.
كيف تستخدم هذه الأنظمة بطريقة مسؤولة؟
ابدأ بتحديد المهمة والبيانات الضرورية فقط، ثم اختبر النظام على أمثلة متنوعة تشمل الصور غير الواضحة والصوت المزعج واللغات واللهجات المختلفة. لا تعتمد على النتيجة وحدها في القرارات الطبية أو القانونية أو المالية أو القرارات التي تؤثر في سلامة الأشخاص، ووفّر مراجعة بشرية مناسبة.
احذف البيانات الشخصية غير الضرورية من الصور والتسجيلات، وتأكد من أن لديك حق مشاركة الملفات. وإذا كان التطبيق يعتمد على مستندات خارجية أيضًا، فراجع مبادئ حماية البيانات والتحكم في الوصول قبل دمجه مع تقنية RAG.
أسئلة شائعة
هل الذكاء الاصطناعي متعدد الوسائط هو نفسه الذكاء الاصطناعي التوليدي؟
ليس تمامًا. تعدد الوسائط يصف أنواع البيانات التي يستطيع النظام معالجتها أو إنتاجها، أما الذكاء الاصطناعي التوليدي فيركز على إنشاء محتوى جديد. قد يكون النظام متعدد الوسائط توليديًا، وقد يقتصر على التحليل أو التصنيف.
هل يستطيع كل نموذج فهم الصور والصوت والفيديو معًا؟
لا. تختلف قدرات النماذج والواجهات، وقد يدعم نموذج الصور دون الفيديو أو الصوت. راجع وثائق النموذج المحدد قبل الاعتماد عليه.
هل تكون نتائج النماذج متعددة الوسائط أدق دائمًا؟
ليس بالضرورة. قد يوفر تعدد الوسائط سياقًا إضافيًا، لكنه قد يضيف أخطاء في قراءة الصور أو محاذاة الصوت والفيديو. تعتمد الدقة على المهمة وجودة البيانات والاختبار.
الخلاصة
يتيح الذكاء الاصطناعي متعدد الوسائط ربط النصوص والصور والصوت والفيديو في عملية تحليل واحدة، ما يفتح تطبيقات مفيدة في التعليم والتواصل وتحليل المحتوى. وتكمن قيمته في جمع الأدلة من أكثر من مصدر، لا في زيادة عدد المدخلات فقط. لذلك يبقى اختيار البيانات المناسبة والتحقق من النتائج وحماية الخصوصية عناصر أساسية عند استخدامه.
المصادر والمراجع
[1] IBM – What is Multimodal AI?
[2] Google AI for Developers – Image Understanding
[3] Google AI for Developers – Video Understanding