تستطيع نماذج الذكاء الاصطناعي إنشاء إجابات مفيدة، لكنها قد تقدم أحيانًا معلومات غير دقيقة أو قديمة. تظهر هنا أهمية تقنية RAG.
إذا كنت مهتمًا بتطبيقات النماذج في سياقات مختلفة، يمكنك قراءة شرح الذكاء الاصطناعي متعدد الوسائط.
تسمح هذه التقنية للنموذج بالبحث في مصادر خارجية قبل صياغة الإجابة، بدل الاعتماد على المعرفة التي اكتسبها أثناء التدريب فقط.
يشرح هذا الدليل معنى RAG، وطريقة عملها، ومكوناتها، واستخداماتها، ومزاياها، والتحديات التي ينبغي الانتباه إليها عند تطبيقها.
ما المقصود بتقنية RAG؟
يشير اختصار RAG إلى Retrieval-Augmented Generation، ويترجم عادةً إلى التوليد المعزز بالاسترجاع. وهي طريقة تجمع بين استرجاع المعلومات وتوليد النصوص.
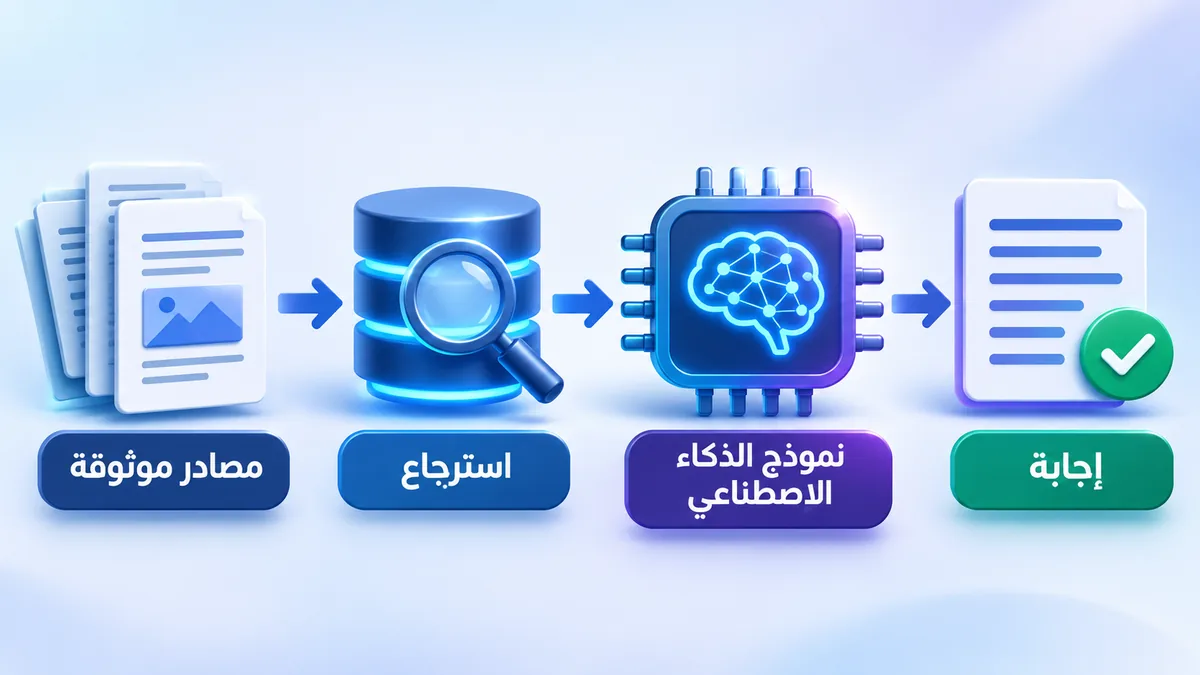
بدل أن يجيب النموذج اعتمادًا على معارفه الداخلية وحدها، يبحث النظام أولًا في مجموعة مستندات أو قواعد بيانات مرتبطة بالسؤال.
بعد العثور على المقاطع المناسبة، يضيفها إلى سياق الطلب ويرسلها إلى النموذج اللغوي. يستخدم النموذج هذه المواد لصياغة إجابة أكثر ارتباطًا بالمصادر.
ولفهم الجزء الخاص بتوليد الإجابة، راجع كيف يعمل الذكاء الاصطناعي التوليدي؟.
لا تعني RAG أن النموذج أصبح معصومًا من الخطأ، بل إنها تمنحه سياقًا إضافيًا يمكن فحصه وتحديثه دون إعادة تدريبه بالكامل.
تختلف هذه الفكرة عن تدريب النموذج على معلومات جديدة؛ فالمعلومات المسترجعة تُقدّم وقت الاستعلام، ويمكن تحديث المستودع بصورة مستقلة.
كيف تعمل RAG خطوة بخطوة؟
تبدأ العملية عندما يرسل المستخدم سؤالًا إلى التطبيق. يحلل النظام السؤال ويحوّله إلى صيغة مناسبة للبحث داخل مصادر المعلومات المتاحة.
قد يستخدم النظام بحثًا نصيًا تقليديًا أو بحثًا دلاليًا يعتمد على تمثيل المعنى. وفي بعض الأنظمة يجمع الطريقتين لتحسين النتائج.
بعد ذلك يسترجع النظام مجموعة من المقاطع التي تبدو أكثر صلة بالسؤال، ثم يرتبها وفق درجة التشابه أو قواعد إضافية.
تُرسل المقاطع المختارة إلى النموذج ضمن تعليمات واضحة تطلب منه الإجابة اعتمادًا على السياق، والإشارة إلى غياب المعلومات عند الحاجة.
ينتج النموذج الإجابة النهائية، وقد يعرض النظام معها أسماء الملفات أو روابط المصادر حتى يستطيع المستخدم مراجعة المعلومات الأصلية.
تعتمد جودة النتيجة على جميع المراحل؛ فالسؤال الغامض أو المستندات الرديئة أو الاسترجاع غير المناسب قد يؤدي إلى إجابة ضعيفة.
المكونات الأساسية لنظام RAG
يحتاج النظام عادةً إلى مصدر بيانات، مثل ملفات PDF أو صفحات داخلية أو مستندات الشركة أو قاعدة معرفة منظمة. ويجب تنظيف هذه المواد قبل استخدامها.
تُقسّم المستندات غالبًا إلى مقاطع أصغر تسمى Chunks، لأن إرسال ملفات طويلة كاملة قد يتجاوز حدود السياق ويصعّب العثور على الجزء المهم.
تُحوّل المقاطع بعد ذلك إلى متجهات رقمية باستخدام نموذج Embedding. تمثل هذه المتجهات المعنى بصورة تسمح بمقارنة السؤال بالمحتوى.
تُخزن المتجهات في قاعدة بيانات متجهية، بينما يمكن الاحتفاظ بالنصوص والبيانات الوصفية في مخزن آخر. عند البحث، تُسترجع المقاطع الأقرب إلى معنى السؤال.
أخيرًا يتولى النموذج اللغوي صياغة الرد. ويمكن إضافة طبقة تحقق أو إعادة ترتيب للمقاطع أو تسجيل للمصادر لرفع جودة النظام وشفافيته.
إقرأ أيضاً… 5 مواقع بعضها عربي: كتابة وإعادة صياغة المقالات عن طريق الذكاء الإصطناعي.
ما الفرق بين RAG والضبط الدقيق للنموذج؟
يهدف الضبط الدقيق Fine-tuning إلى تعديل سلوك النموذج أو تحسين أدائه في مهمة محددة عبر تدريبه على أمثلة إضافية. أما RAG فتضيف معلومات خارجية وقت الإجابة.
إذا كانت الشركة تريد تعليم النموذج أسلوبًا محددًا في الرد أو تنسيقًا ثابتًا، فقد يكون الضبط الدقيق مناسبًا. أما إذا كانت تحتاج إلى الإجابة عن وثائق تتغير باستمرار، فقد تكون RAG أنسب.
تحديث قاعدة معرفة RAG قد يكون أسهل من إعادة تدريب النموذج عند تغيير سياسات الشركة أو أسعار منتجاتها أو أدلة الاستخدام.
لا توجد قاعدة تمنع الجمع بين الأسلوبين؛ فقد يستخدم التطبيق نموذجًا مضبوطًا على مجال معين، مع نظام استرجاع يزوده بالمعلومات الحديثة ذات الصلة.
يعتمد الاختيار على طبيعة البيانات والميزانية والخصوصية وسرعة التحديث، وليس على اعتبار إحدى التقنيتين بديلًا كاملًا عن الأخرى.
أهم استخدامات RAG في المؤسسات
يمكن بناء مساعد داخلي يبحث في سياسات الموارد البشرية وإجراءات العمل، فيجيب الموظفين عن الإجازات والمزايا والخطوات الإدارية استنادًا إلى المستندات المعتمدة.
وفي خدمة العملاء، يمكن ربط المساعد بأدلة المنتجات وقواعد الأسئلة الشائعة، ليقدم تعليمات متوافقة مع إصدار المنتج أو سياسة الدعم الحالية.
تستفيد الفرق القانونية والبحثية من البحث في مجموعات كبيرة من العقود والتقارير والأوراق، مع ضرورة مراجعة المختصين وعدم اعتبار المخرجات استشارة نهائية.
كما يمكن استخدامها في التعليم للوصول إلى محتوى المقررات، وفي التجارة الإلكترونية لتوضيح خصائص المنتجات، وفي الصيانة للبحث داخل كتيبات المعدات.
تكون الفائدة أكبر عندما تكون المعلومات موزعة على ملفات كثيرة ويحتاج المستخدم إلى إجابة مركبة مع إمكانية العودة إلى المصدر الأصلي.
مزايا التقنية وحدودها ومخاطرها
من أبرز مزايا RAG إمكانية تحديث المعلومات دون إعادة تدريب النموذج، وربط الإجابة بمصادر محددة، وتقليل الاعتماد على المعرفة العامة غير المرتبطة بسياق المؤسسة.
لكن الاسترجاع لا يضمن صحة المستند نفسه. فإذا كانت قاعدة المعرفة قديمة أو متناقضة، فقد ينقل النظام الخطأ إلى الإجابة بثقة.
قد يفشل البحث الدلالي في العثور على مستند مهم، أو يسترجع مقطعًا قريبًا لغويًا لكنه لا يجيب عن السؤال فعليًا.
هناك أيضًا مخاطر تتعلق بالخصوصية؛ إذ يجب تحديد صلاحيات الوصول حتى لا تظهر للمستخدم معلومات لا يحق له الاطلاع عليها.
ومن المهم الحماية من تعليمات خبيثة قد تكون مدسوسة داخل مستند مسترجع، مع اختبار النظام وتسجيل عملياته ومراجعة المخرجات الحساسة.
كيف تقيس جودة نظام RAG؟
لا يكفي تقييم جمال صياغة الإجابة. ينبغي قياس ما إذا كانت المقاطع المسترجعة ذات صلة، وما إذا كانت الإجابة تستند فعلًا إلى تلك المقاطع.
يمكن اختبار دقة الاسترجاع عبر مجموعة أسئلة لها مصادر معروفة، ثم فحص مدى ظهور المقاطع الصحيحة ضمن النتائج الأولى.
كما ينبغي تقييم أمانة الإجابة للمصادر، واكتمالها، ووضوح الإحالات، وقدرة النظام على الاعتراف عندما لا تتوفر معلومة كافية.
تساعد مراجعة عينات حقيقية من الاستخدام على اكتشاف الأسئلة التي يفشل فيها النظام، ثم تحسين تقسيم المستندات والفهرسة وتعليمات النموذج.
ينبغي كذلك مراقبة زمن الاستجابة وتكلفة الاستعلام، لأن زيادة عدد المقاطع المسترجعة قد تحسن التغطية لكنها ترفع التكلفة وتزيد التشويش.
إقرأ أيضاً… أفضل 11 موقع وأداة تعديل فيديو بالذكاء الاصطناعي.
هل RAG مناسبة لمشروعك؟
تكون RAG خيارًا منطقيًا عندما تحتاج إلى إجابات تعتمد على ملفات أو بيانات خاصة أو معلومات تتغير بوتيرة أسرع من دورات تدريب النماذج.
قبل البدء، حدد الأسئلة التي تريد الإجابة عنها، ومصادرها، ومن يملك حق الوصول إليها، وكيف ستحدّثها وتراجع جودتها.
ابدأ بنطاق صغير ومجموعة مستندات موثوقة، ثم أنشئ أسئلة اختبار واقعية وقارن الإجابات بالمصادر الأصلية قبل توسيع النظام.
إذا كان المطلوب مجرد كتابة عامة أو تلخيص نص يقدمه المستخدم، فقد لا تحتاج إلى بنية RAG كاملة؛ فقد تكفي أداة ذكاء اصطناعي تقليدية.
الخلاصة أن RAG ليست مجرد إضافة تقنية، بل طريقة لبناء تطبيقات أكثر ارتباطًا بمصادر المعرفة، بشرط إدارة البيانات والاختبار والصلاحيات بعناية.
وتعتمد بعض تطبيقات RAG على قاعدة بيانات متجهية لتنفيذ البحث الدلالي واسترجاع المقاطع الأقرب إلى السؤال.
أسئلة شائعة حول RAG
هل تمنع RAG هلوسة الذكاء الاصطناعي؟
لا تمنعها تمامًا، لكنها قد تقللها عندما تسترجع مصادر مناسبة وتُلزم النموذج بالاستناد إليها.
هل تحتاج RAG إلى قاعدة بيانات متجهية؟
ليس دائمًا؛ يمكن استخدام البحث النصي أو قواعد بيانات تدعم البحث المتجهي، وفق طبيعة المشروع.
هل RAG نموذج ذكاء اصطناعي مستقل؟
لا، إنها بنية أو أسلوب يربط نموذجًا لغويًا بمصادر خارجية لاسترجاع المعلومات قبل التوليد.
هل يمكن تحديث المعلومات يوميًا؟
نعم، يمكن إعادة فهرسة المستندات أو تحديث السجلات وفق جدول أو عند حدوث تغيير في المصدر.
المصادر والمراجع
[1] Lewis وآخرون – Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks