ما هو RAG في الذكاء الاصطناعي؟ شرح التوليد المعزز بالاسترجاع
تخيّل أن تسأل مساعدًا ذكيًا عن سياسة الإجازات في شركتك، فيرجع إلى دليل الموظفين المعتمد ثم يجيبك مع الإشارة إلى الصفحة التي استند إليها. هذه الفكرة هي جوهر تقنية التوليد المعزز بالاسترجاع (Retrieval-Augmented Generation أو RAG): ربط نموذج اللغة بمصادر معلومات خارجية ذات صلة قبل أن ينشئ الإجابة.
تساعد RAG النماذج اللغوية الكبيرة على استخدام معلومات متخصصة أو حديثة لا يلزم أن تكون موجودة ضمن بيانات تدريبها. لكنها لا تجعل الإجابات صحيحة تلقائيًا؛ إذ تعتمد الجودة على دقة المستندات، وجودة الاسترجاع، وطريقة استخدام النموذج للمعلومات التي عُرضت عليه.
ما هو RAG في الذكاء الاصطناعي؟
RAG اختصار لعبارة Retrieval-Augmented Generation، ويمكن ترجمتها إلى «التوليد المعزز بالاسترجاع». وهي بنية تقنية تجمع بين جزأين: نظام يسترجع المعلومات من قاعدة معرفة أو مصادر خارجية، ونموذج ذكاء اصطناعي توليدي يستخدم المعلومات المسترجعة لصياغة إجابة باللغة الطبيعية.
بدل أن يعتمد النموذج على ما تعلمه أثناء التدريب فقط، يحصل قبل الإجابة على مقاطع مرتبطة بسؤال المستخدم. وقد تأتي هذه المقاطع من ملفات PDF أو مستندات الشركة أو قواعد البيانات أو صفحات الموقع أو مصادر أخرى يحددها مطوّر النظام.
ترتبط التقنية مباشرة بعمل نماذج اللغة الكبيرة (LLM)، وهي أحد الأساليب التي توسّع قدرة تطبيقات الذكاء الاصطناعي التوليدي لتتعامل مع معلومات خاصة بمجال أو مؤسسة.
كيف تعمل تقنية RAG خطوة بخطوة؟
تتكون البنية الأساسية من مرحلة تجهيز المعرفة، ثم مرحلة البحث والاستجابة. وقد تختلف التفاصيل بين الأنظمة، لكن المسار الشائع يمر بالمراحل التالية:
1. جمع البيانات وتجهيزها
تُجمع المستندات التي يُسمح للنظام باستخدامها، مثل أدلة المنتجات والأسئلة الشائعة والسياسات والتقارير. ثم تُستخرج النصوص منها وتُنظَّف من العناصر غير الضرورية، مع الاحتفاظ بمعلومات مهمة مثل عنوان المستند ورقمه وتاريخ تحديثه وصلاحيات الوصول إليه.
2. تقسيم المستندات إلى مقاطع
غالبًا ما تكون المستندات أطول من أن تُرسل كاملة مع كل سؤال، لذلك تُقسّم إلى مقاطع أصغر تسمى Chunks. يجب أن يكون المقطع كبيرًا بما يكفي ليحافظ على معنى الفقرة، وصغيرًا بما يكفي كي لا يحمل معلومات كثيرة غير مرتبطة بالسؤال. وقد تتداخل أجزاء متجاورة قليلًا حتى لا تضيع الجمل التي يتصل معناها بين مقطعين.
3. تحويل النص إلى Embeddings
يحوّل نموذج التضمين (Embedding Model) كل مقطع إلى تمثيل رقمي يُسمى متجهًا. يساعد هذا التمثيل نظام البحث على مقارنة المعاني المتقاربة، وليس الكلمات المتطابقة فقط. فمثلًا، يمكن أن يتقارب سؤال «كيف أستعيد كلمة المرور؟» مع مقطع يتحدث عن «إعادة تعيين بيانات الدخول» حتى لو اختلفت صياغة العبارتين.
4. استرجاع المقاطع الأكثر صلة
عندما يرسل المستخدم سؤالًا، يُحوَّل السؤال عادة إلى تمثيل مناسب للبحث، ثم يُستخدم للعثور على المقاطع الأقرب إلى معناه داخل فهرس البحث. وقد يجمع النظام بين البحث الدلالي والبحث بالكلمات المفتاحية، وهو ما يُعرف بالبحث الهجين (Hybrid Search).
5. ترتيب النتائج وبناء سياق الإجابة
قد يسترجع النظام عددًا من المقاطع، ثم يعيد ترتيبها بحسب مدى صلتها بالسؤال. بعد ذلك يضيف المقاطع الأفضل إلى تعليمات النموذج مع سؤال المستخدم، لتكوين سياق أكثر تحديدًا من السؤال وحده.
6. إنشاء الإجابة والتحقق منها
يستخدم النموذج السياق المسترجع لصياغة الإجابة. ويمكن للتطبيق إرفاق أسماء المستندات أو أرقام الصفحات أو الروابط التي استند إليها، حتى يستطيع المستخدم مراجعة المصدر. ويُفضّل تقييم النظام دوريًا للتأكد من أن المقاطع المسترجعة ذات صلة وأن الإجابات لا تتجاوز ما تسمح به المصادر.
هذا التسلسل يوضح لماذا تتكون تسمية RAG من ثلاثة أجزاء: استرجاع المعلومات، ثم إضافة سياقها إلى الطلب، ثم توليد الإجابة.
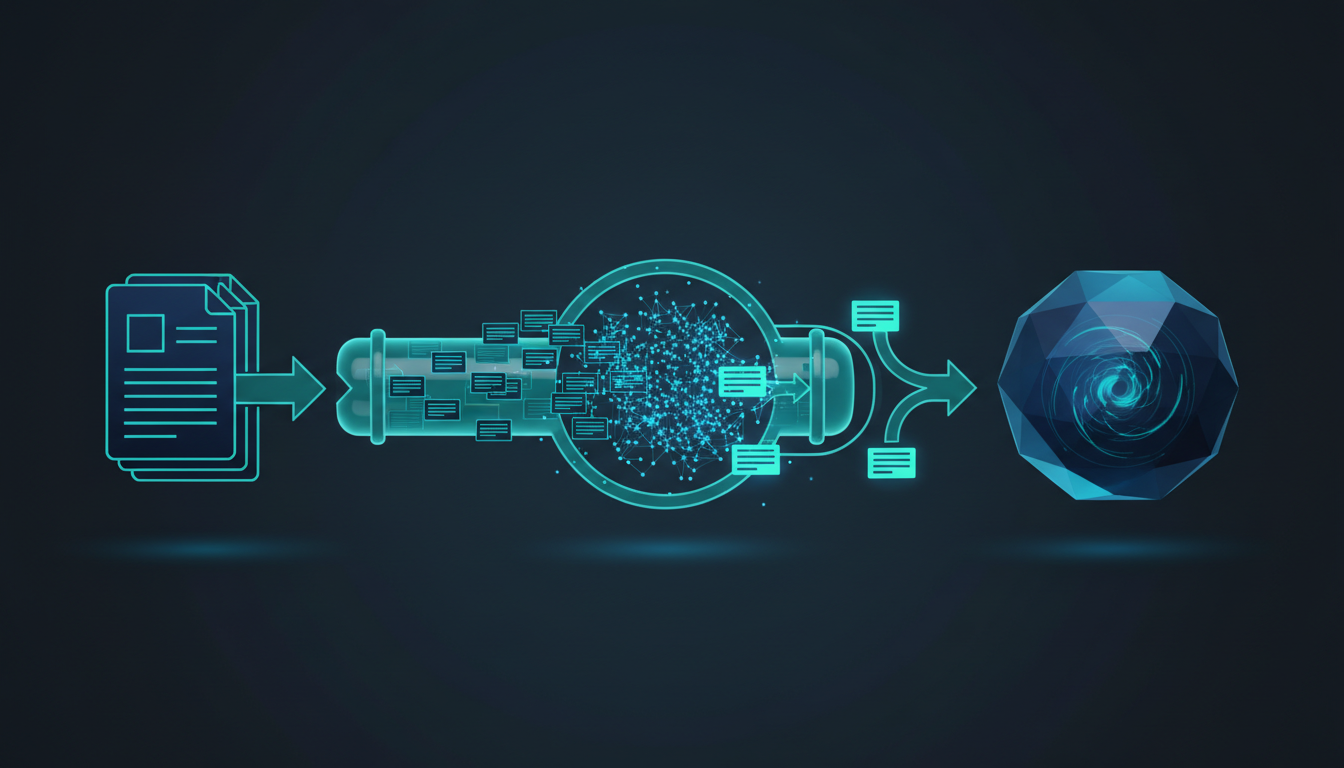
مثال عملي: كيف تجيب RAG عن سؤال من دليل شركة؟
لنفترض أن مؤسسة لديها مئات الصفحات من سياسات الموارد البشرية، وأن موظفًا سأل: «كم يومًا يمكنني ترحيل الإجازة السنوية إلى العام المقبل؟». من دون RAG قد يقدّم النموذج إجابة عامة لا تعكس سياسة المؤسسة أو قد لا يعرفها أصلًا.
- يستقبل النظام السؤال ويحدد أن الموضوع يتعلق بترحيل الإجازات.
- يبحث في دليل الموظفين عن المقاطع التي تتحدث عن رصيد الإجازات والترحيل.
- يرتب النتائج ويختار الفقرات الأقرب إلى السؤال.
- يرسل هذه الفقرات مع السؤال إلى نموذج اللغة.
- ينشئ النموذج إجابة مرتبطة بالنص المسترجع، مع ذكر اسم الدليل ورقم القسم إن توفرت البيانات.

يمكن أن تكون تعليمات النموذج بالعربية على النحو الآتي:
أجب عن سؤال المستخدم اعتمادًا على المقاطع المسترجعة المرفقة فقط. لا تضف سياسة أو رقمًا غير موجود في هذه المقاطع. اذكر اسم المصدر أو رقم الصفحة عند توفره. إذا لم تتضمن المعلومات إجابة كافية، فقل بوضوح إن المصادر المتاحة لا تكفي للإجابة، ولا تخمّن.
هذه التعليمات تساعد على تقليل الإجابات غير المدعومة، لكنها لا تغني عن اختبار النظام ومراجعة صلاحيات الوصول وجودة المستندات.
ما الفرق بين RAG والضبط الدقيق Fine-tuning؟
| وجه المقارنة | RAG | الضبط الدقيق |
|---|---|---|
| الفكرة الأساسية | استرجاع معلومات خارجية وإضافتها إلى سياق السؤال | تدريب النموذج مرة إضافية على أمثلة أو بيانات متخصصة |
| تحديث المعرفة | يمكن تحديث المستندات والفهرس دون إعادة تدريب النموذج | قد يتطلب إعداد مجموعة تدريب جديدة وتنفيذ عملية ضبط جديدة |
| الاستخدام الشائع | الأسئلة عن سياسات أو وثائق أو معلومات تتغير | تحسين أسلوب النموذج أو سلوكه أو أدائه في مهمة محددة |
| المتطلبات | مصادر منظمة نسبيًا، واسترجاع جيد، وربط آمن بالنموذج | بيانات تدريب مناسبة، وتقييم، وموارد تدريب |
ليست الطريقتان بديلتين متعارضتين دائمًا؛ فقد تستخدم المؤسسة الضبط الدقيق لتكييف سلوك النموذج، وتستخدم RAG لتزويده بالمعلومات التي تتغير أو تحتاج إلى الرجوع إلى مصدر محدد.
ما فوائد استخدام RAG؟
- الوصول إلى معلومات حديثة: يمكن تحديث قاعدة المعرفة دون انتظار إعادة تدريب النموذج الأساسي.
- تخصيص الإجابات: يستطيع النظام استخدام أدلة أو وثائق خاصة بمؤسسة أو مجال معين.
- سهولة مراجعة المصادر: يمكن إظهار المستندات والمقاطع التي دعمت الإجابة.
- تقليل بعض أنواع الهلوسة: تزويد النموذج بمعلومات ذات صلة قد يقلل اعتماده على التخمين، لكنه لا يزيل الأخطاء نهائيًا.
- مرونة إدارة المعرفة: يمكن تعديل مصادر المعلومات أو سحبها أو تحديثها دون تعديل أوزان النموذج نفسه.
ما حدود RAG ومخاطره؟
لا تضمن RAG صحة الإجابة؛ فقد يسترجع النظام مستندًا قديمًا أو مقطعًا خارج السياق، وقد يسيء النموذج فهم النص أو يضيف استنتاجًا غير مدعوم. لذلك ينبغي قياس جودة الاسترجاع وجودة الإجابة كلٌّ على حدة، مع اختبار أسئلة حقيقية ومتنوعة.
- جودة البيانات: المستندات المتناقضة أو القديمة تؤدي إلى سياق مضلل.
- ضعف الاسترجاع: قد لا يجد النظام المقطع الصحيح أو قد يختار مقاطع كثيرة غير مفيدة.
- أمن المعلومات: يجب ألا يسترجع المستخدم مستندات لا يملك صلاحية الاطلاع عليها؛ لذلك ينبغي تطبيق صلاحيات الوصول قبل عرض المقاطع للنموذج.
- حقن التعليمات: قد تحتوي وثيقة مسترجعة على نص خبيث يحاول توجيه النموذج. يجب التعامل مع المحتوى المسترجع بوصفه بيانات غير موثوقة، لا تعليمات أعلى أولوية.
- الاستشهادات غير الكافية: ظهور رابط مصدر لا يعني أن كل جملة في الإجابة مدعومة فعلًا بذلك المصدر؛ يلزم التحقق من مدى التطابق.
ومن المهم مراجعة سياسات التعامل مع البيانات قبل ربط أي مساعد ذكي بمستندات داخلية أو معلومات شخصية. يمكنك أيضًا الاطلاع على مقال هل الذكاء الاصطناعي آمن على الخصوصية؟ ونصائح حماية الخصوصية عند استخدام الذكاء الاصطناعي.
متى تكون RAG خيارًا مناسبًا؟
تكون RAG مناسبة عندما تحتاج إلى إجابات مبنية على مجموعة وثائق أو بيانات محددة، خصوصًا إذا كانت هذه البيانات تتغير باستمرار أو يجب أن يستطيع المستخدم الرجوع إلى مصدرها. ومن أمثلتها مساعد خدمة العملاء، والبحث في أدلة التشغيل، ومساعدة الموظفين على الوصول إلى السياسات، والبحث في الأبحاث والتقارير.
أما إذا كان المطلوب مجرد تحسين أسلوب كتابة النموذج أو تنسيق مخرجاته، فقد يكون ضبط التعليمات أو الضبط الدقيق أنسب وأبسط. وإذا كانت المعلومات قليلة ويمكن إرسالها مباشرة ضمن سياق الطلب، فقد لا تكون هناك حاجة إلى بناء نظام RAG كامل.
يمكن تنفيذ الفكرة مع نماذج مختلفة، مثل Gemini أو ChatGPT أو Claude، بحسب واجهة البرمجة والبنية التي يختارها المطور. التقنية ليست حصرية لمزوّد واحد؛ فهي نمط معماري يمكن ربطه بنماذج وخدمات بحث مختلفة.
أسئلة شائعة حول تقنية RAG
هل تجعل RAG إجابات الذكاء الاصطناعي صحيحة دائمًا؟
لا. يمكن أن تقلل RAG بعض الأخطاء عندما تسترجع مصادر موثوقة وذات صلة، لكنها قد تفشل إذا كانت البيانات غير صحيحة أو الاسترجاع ضعيفًا أو أساء النموذج تفسير السياق.
هل تحتاج RAG إلى قاعدة بيانات متجهية؟
تستخدم تطبيقات كثيرة قواعد بيانات متجهية لتخزين التضمينات والبحث الدلالي، لكن ليس كل نظام RAG ملزمًا باستخدام قاعدة متجهية منفصلة؛ فقد يستخدم بحثًا نصيًا أو هجينًا أو محرك استرجاع آخر.
هل تحتاج RAG إلى إعادة تدريب نموذج اللغة؟
لا. الفكرة الأساسية هي استرجاع المعلومات عند الحاجة وإضافتها إلى سياق الطلب، بدل إدخال كل معلومة جديدة في أوزان النموذج عبر إعادة التدريب.
هل يمكن استخدام RAG مع ملفات PDF؟
نعم. يمكن استخراج النص من ملفات PDF، وتقسيمه إلى مقاطع، ثم فهرسته لاسترجاع الأجزاء المرتبطة بسؤال المستخدم. ويجب الانتباه إلى جودة استخراج الجداول والصور والصفحات الممسوحة ضوئيًا.
الخلاصة
تربط تقنية RAG نماذج اللغة بمصادر معلومات خارجية، فتسترجع المقاطع المرتبطة بالسؤال وتضيفها إلى السياق قبل إنشاء الإجابة. وهي مفيدة عندما تحتاج التطبيقات إلى معرفة متخصصة أو حديثة أو قابلة للمراجعة، لكنها تعتمد على جودة البيانات والاسترجاع والأمان والتقييم. لذلك يجب النظر إليها بوصفها وسيلة لتحسين grounding الإجابات، لا ضمانًا مطلقًا لصحتها.
المصادر والمراجع
[1] IBM – What is Retrieval-Augmented Generation (RAG)?
[2] Google Cloud – What is Retrieval-Augmented Generation (RAG)?