ما هو التعلم الآلي الفيدرالي؟ كيف يعمل ويحمي خصوصية البيانات؟
تخيّل أن هاتفك يتعلم اقتراح الكلمات التي تكتبها بصورة أفضل، من دون أن يرسل سجل كتابتك كاملًا إلى خادم مركزي. هذه الفكرة قريبة من التعلم الآلي الفيدرالي (Federated Learning)، وهو أسلوب يدرّب نموذجًا مشتركًا بالاستفادة من بيانات موزعة على أجهزة أو مؤسسات متعددة، مع إبقاء بيانات التدريب الأصلية محليًا قدر الإمكان.
لا يعني ذلك أن البيانات أصبحت محمية تلقائيًا أو أن أي معلومات لا تغادر الجهاز مطلقًا؛ فقد تُرسل تحديثات النموذج أو إحصاءات مشتقة منه، وهذه التحديثات نفسها قد تحمل مخاطر خصوصية. لذلك تُستخدم تقنيات إضافية مثل التجميع الآمن والخصوصية التفاضلية، وتختلف الضمانات بحسب تصميم النظام.
ما هو التعلم الآلي الفيدرالي؟
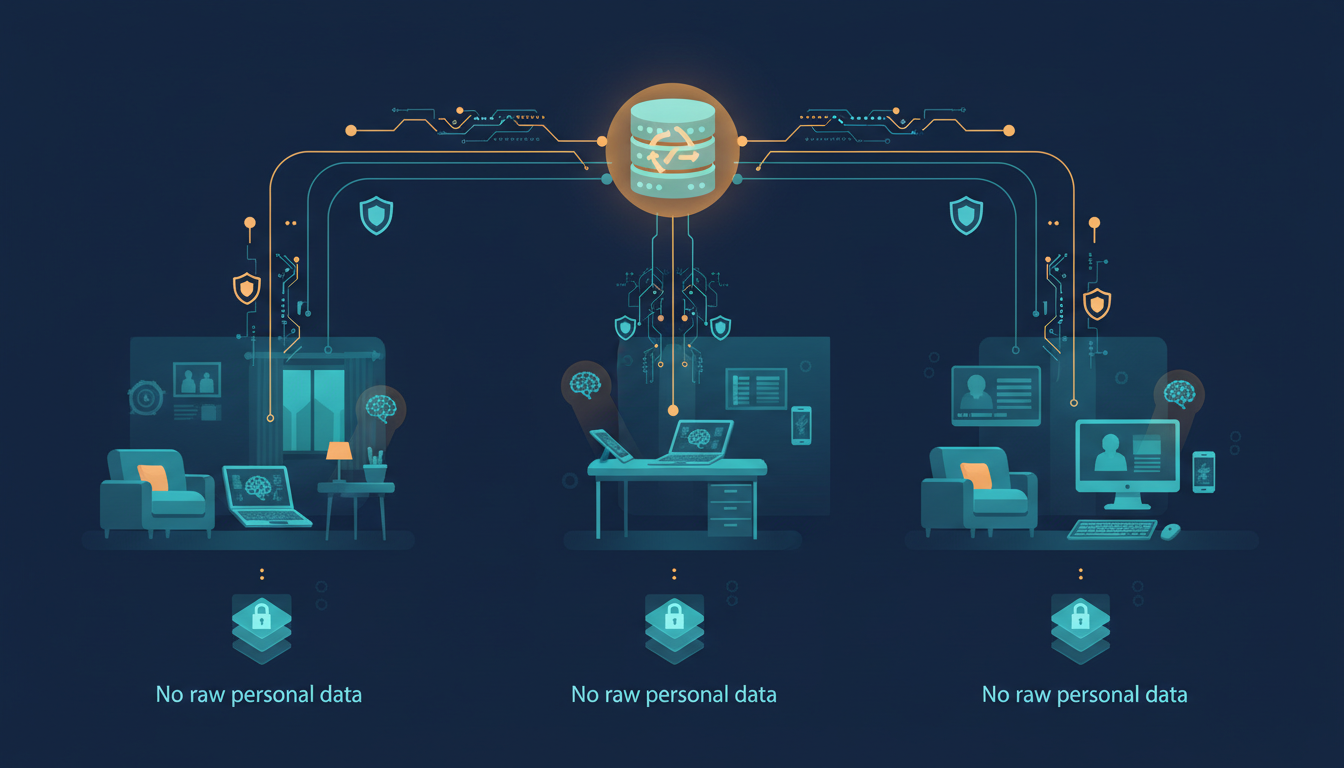
التعلم الآلي الفيدرالي هو طريقة لتدريب نموذج واحد أو نموذج مشترك بالتعاون بين عدة أطراف، مثل الهواتف أو المستشفيات أو فروع مؤسسة، بدل جمع جميع بياناتها الخام في قاعدة مركزية واحدة. يحتفظ كل طرف ببياناته محليًا وينفذ جزءًا من التدريب، ثم يرسل تحديثًا للنموذج وفق بروتوكول محدد ليُدمج مع تحديثات المشاركين الآخرين.
الهدف هو الاستفادة من الأنماط الموجودة في بيانات موزعة مع تقليل الحاجة إلى نقل السجلات الأصلية. ويُستخدم المصطلح أحيانًا في أنظمة تتعاون فيها أجهزة كثيرة، وأحيانًا في بيئات تتعاون فيها مؤسسات تملك مجموعات بيانات منفصلة.
يرتبط هذا المجال بمفاهيم التعلم العميق وبناء النماذج، لكنه يضيف بُعدًا مهمًا يتعلق بمكان وجود البيانات وكيفية تنسيق التدريب بين المشاركين.
كيف يعمل التعلم الفيدرالي خطوة بخطوة؟
تُنفّذ العملية عادة على شكل جولات تدريب متكررة. قد تختلف التفاصيل التقنية بين الأنظمة، لكن النموذج الشائع يمر بالمراحل التالية:
- تهيئة النموذج: ينشئ الخادم نموذجًا أوليًا ويحدد المشاركين وسياسات التدريب والبيانات أو المهام المسموح بها.
- إرسال النموذج: يرسل الخادم نسخة من النموذج أو أوزانه الحالية إلى مجموعة من الأجهزة أو المؤسسات المشاركة.
- التدريب المحلي: يستخدم كل مشارك بياناته المحلية لتحديث النموذج، من دون الحاجة إلى إرسال مجموعة البيانات الخام كاملة.
- إرسال التحديثات: يرسل المشاركون تحديثات الأوزان أو التدرجات أو إحصاءات محددة إلى جهة التجميع، وغالبًا عبر قناة محمية.
- تجميع التحديثات: يجمع الخادم التحديثات وفق خوارزمية مثل المتوسط الفيدرالي (Federated Averaging) لإنتاج نموذج عام محدّث.
- تكرار الجولة: يعيد الخادم إرسال النموذج المحسّن إلى المشاركين، وتتكرر العملية حتى يتحقق مستوى الأداء المطلوب.
مثال عملي: كيف يتعلم الهاتف اقتراح الكلمات؟
لنفترض أن آلاف الهواتف تستخدم لوحة مفاتيح تتعلم اقتراح الكلمات التالية. تختلف الكلمات والعبارات التي يكتبها كل مستخدم، وقد تحتوي هذه البيانات على معلومات شخصية لا يرغب في إرسالها إلى جهة مركزية.
- يحتفظ كل هاتف بسجل التدريب المسموح به محليًا وفق إعدادات التطبيق.
- يتلقى الهاتف نسخة من نموذج الاقتراحات.
- ينفذ تدريبًا محليًا على أمثلة مناسبة من بياناته.
- يرسل تحديثًا للنموذج، لا ملفًا كاملًا يحتوي على سجل الكتابة.
- تُجمع تحديثات عدد كبير من الأجهزة لإنتاج نموذج عام أفضل.
توضح Google Research استخدام التعلم الفيدرالي في ميزات مثل اقتراح الكلمات في Gboard والردود الذكية.
ومن المهم ملاحظة أن تصميمات التعلم الفيدرالي تتطور؛ ففي 2 أكتوبر 2026 أعلنت Google عن بنية جديدة تنقل جزءًا من تنفيذ التدريب إلى بيئات تنفيذ موثوقة على الخادم (TEE).
في هذا التصميم تُرفع أمثلة التدريب مشفرة وفق سياسات وصول مسبقة، ولا يُسمح بمعالجتها إلا داخل بيئات موثوقة محددة، مع إتاحة نتائج مجهّلة وأوزان نموذج محمية بالخصوصية التفاضلية.
لذلك لا يعني التعلم الفيدرالي دائمًا أن كل البيانات تبقى ماديًا على الجهاز؛ بل يعتمد مستوى الحماية على طريقة نقل البيانات وتشفيرها وتنفيذها والتحقق من السياسات.

ما الفرق بين التعلم الفيدرالي والتعلم المركزي؟
| وجه المقارنة | التعلم المركزي | التعلم الفيدرالي |
|---|---|---|
| مكان بيانات التدريب | تُجمع عادة في مستودع مركزي | تبقى موزعة لدى الأجهزة أو المؤسسات |
| مكان تنفيذ التدريب | على الخوادم المركزية غالبًا | محليًا لدى المشاركين مع تجميع التحديثات |
| نقل البيانات | قد يتطلب نقل السجلات أو الأمثلة الخام | يركز على نقل تحديثات النموذج أو إحصاءات محددة |
| التحديات | حماية قاعدة البيانات المركزية وإدارتها | تنسيق المشاركين، تفاوت الأجهزة، وحماية التحديثات |
التعلم الفيدرالي ليس هو التحليلات الفيدرالية
هناك مفهوم قريب يسمى التحليلات الفيدرالية (Federated Analytics). في التعلم الفيدرالي يكون الهدف تدريب نموذج تعلم آلي، أما التحليلات الفيدرالية فتركز على حساب إحصاءات أو مؤشرات مجمعة من بيانات تبقى محليًا، مثل حساب عدد مرات استخدام ميزة معينة من دون جمع سجل كل مستخدم.
قد تستخدم الأنظمة البنيتين معًا: تحليلات محلية لقياس جودة النموذج، وتعلمًا فيدراليًا لتحسينه. لكنهما ليسا المصطلح نفسه ولا يؤديان المهمة ذاتها.
هل يحمي التعلم الفيدرالي الخصوصية بالكامل؟
يساعد إبقاء البيانات الخام في مكانها على تقليل نقل المعلومات الشخصية، لكنه لا يضمن الخصوصية بمفرده. فقد تكشف تحديثات النموذج بعض الأنماط أو تسمح بهجمات استنتاج أو إعادة بناء في ظروف معينة. لذلك يجب تصميم الحماية على عدة طبقات.
التجميع الآمن Secure Aggregation
تسمح بروتوكولات التجميع الآمن للخادم بالحصول على مجموع أو متوسط تحديثات المشاركين من دون الاطلاع على تحديث كل مشارك منفردًا. ويشرح NIST أمثلة على استخدام تقنيات التشفير وتقاسم الأسرار لحماية التحديثات أثناء التجميع.
الخصوصية التفاضلية Differential Privacy
تضيف الخصوصية التفاضلية ضوضاء محسوبة إلى النتائج أو التحديثات، بهدف الحد من مقدار ما يمكن استنتاجه عن مساهمة فرد واحد. يجب ضبط مقدار الضوضاء ومحاسبة ميزانية الخصوصية؛ فزيادة الحماية قد تؤثر في دقة النموذج.
بيئات التنفيذ الموثوقة والتشفير
قد تستخدم بعض الأنظمة بيئات تنفيذ موثوقة (Trusted Execution Environments) لتقييد طريقة معالجة البيانات والتحقق من الكود الذي ينفذها، إلى جانب تشفير النقل والتخزين والتحكم في الصلاحيات. وتظل هذه الضوابط مرتبطة بحدود العتاد والتنفيذ وإدارة المفاتيح.
للتوسع في هذا الجانب، يمكنك قراءة مقال هل الذكاء الاصطناعي آمن على الخصوصية؟، وراجع أيضًا نصائح حماية الخصوصية عند استخدام الذكاء الاصطناعي.
أهم استخدامات التعلم الفيدرالي
- لوحات المفاتيح والهواتف: تحسين اقتراح الكلمات والتصحيح والتخصيص اعتمادًا على أنماط الاستخدام المحلية.
- الرعاية الصحية والبحث: تدريب نماذج مشتركة بين مؤسسات تحتفظ بسجلاتها الطبية داخل أنظمتها، مع ضرورة الالتزام بالموافقات والحوكمة والأنظمة الصحية.
- الخدمات المالية: التعاون على كشف أنماط الاحتيال بين مؤسسات لا تستطيع مشاركة بيانات العملاء الخام بسهولة.
- إنترنت الأشياء: تحسين نماذج الأجهزة الطرفية التي تجمع بياناتها محليًا، مثل المستشعرات والمعدات الصناعية.
ما تحديات التعلم الآلي الفيدرالي؟
- اختلاف البيانات: قد تختلف البيانات بين جهاز وآخر أو مؤسسة وأخرى، فلا تمثل كل مجموعة التوزيع نفسه.
- ضعف الاتصال والموارد: بعض الأجهزة لا تملك اتصالًا مستقرًا أو قدرة حسابية كافية للمشاركة في كل جولة.
- الهجمات على التحديثات: قد يرسل مشارك خبيث تحديثات مضللة أو يحاول تسميم النموذج.
- تكلفة التنسيق: يتطلب إرسال التحديثات وتجميعها وإدارة المشاركين بنية تقنية واستهلاكًا للاتصال والطاقة.
- الخصوصية ليست تلقائية: يجب اختبار احتمالات تسرب المعلومات من التحديثات والنموذج النهائي، وعدم الاكتفاء بعدم إرسال البيانات الخام.
متى يكون التعلم الفيدرالي خيارًا مناسبًا؟
يكون مناسبًا عندما تكون البيانات موزعة فعلًا، وتوجد أسباب قانونية أو تشغيلية أو تتعلق بالثقة تجعل جمعها مركزيًا صعبًا، ويمكن للأطراف المشاركة تشغيل التدريب المحلي وإرسال التحديثات بأمان. أما إذا كانت البيانات متاحة بالفعل في بيئة مركزية موثوقة، فقد يكون التدريب المركزي أبسط وأقل تكلفة.
أسئلة شائعة
هل تغادر البيانات الجهاز في التعلم الفيدرالي؟
في التصميم الشائع تبقى بيانات التدريب الخام محليًا، لكن قد تغادر تحديثات النموذج أو إحصاءات مشتقة. لذلك لا يصح القول إن أي معلومات لا تغادر الجهاز في كل الأنظمة.
هل التعلم الفيدرالي يمنع تسرب البيانات؟
لا يضمن ذلك وحده. تُستخدم معه تقنيات مثل التجميع الآمن والخصوصية التفاضلية والتشفير وضوابط الوصول لتقليل المخاطر، ويجب تقييم كل نظام بحسب تصميمه.
ما الفرق بين التعلم الفيدرالي والتعلم الموزع؟
في التعلم الموزع قد تُقسّم البيانات أو الحسابات بين عدة أجهزة ضمن بيئة تدريب مشتركة، بينما يركز التعلم الفيدرالي على تعاون أطراف تحتفظ ببياناتها محليًا ولا تشارك السجلات الخام عادة.
هل يستخدم التعلم الفيدرالي في الهواتف؟
نعم، من أمثلته تحسين نماذج اقتراح الكلمات وبعض الميزات التي تتعلم من بيانات الاستخدام المحلية، بشرط تطبيق ضوابط الخصوصية المناسبة.
الخلاصة
يتيح التعلم الآلي الفيدرالي تدريب نموذج مشترك من بيانات موزعة من دون الحاجة إلى جمع كل البيانات الخام في خادم واحد. وتكمن قوته في الجمع بين التعلم والتعاون مع تقليل نقل البيانات، لكن نجاحه يتطلب معالجة اختلاف البيانات وأمن التحديثات وتكلفة الاتصال والحوكمة. لذلك ينبغي اعتباره نهجًا لتحسين الخصوصية، لا ضمانًا مطلقًا لها.
المصادر والمراجع
[1] Google Research – Toward Provably Private Learning from Federated Data
[2] NIST – Protecting Model Updates in Privacy-Preserving Federated Learning
[3] TensorFlow Federated – Tutorials Overview
[4] arXiv – Toward Provably Private Learning from Federated Data